La supervision ScalarX repose sur une approche décentralisée, pensée pour les infrastructures qui ne tournent pas toujours dans un seul datacenter, ni même sur un seul continent.
ScalarX ne centralise pas artificiellement ce qui doit rester distribué. Nos clients peuvent avoir des serveurs dans plusieurs pays, chez plusieurs providers ou dans leurs propres datacenters. Notre supervision est conçue pour cette réalité.
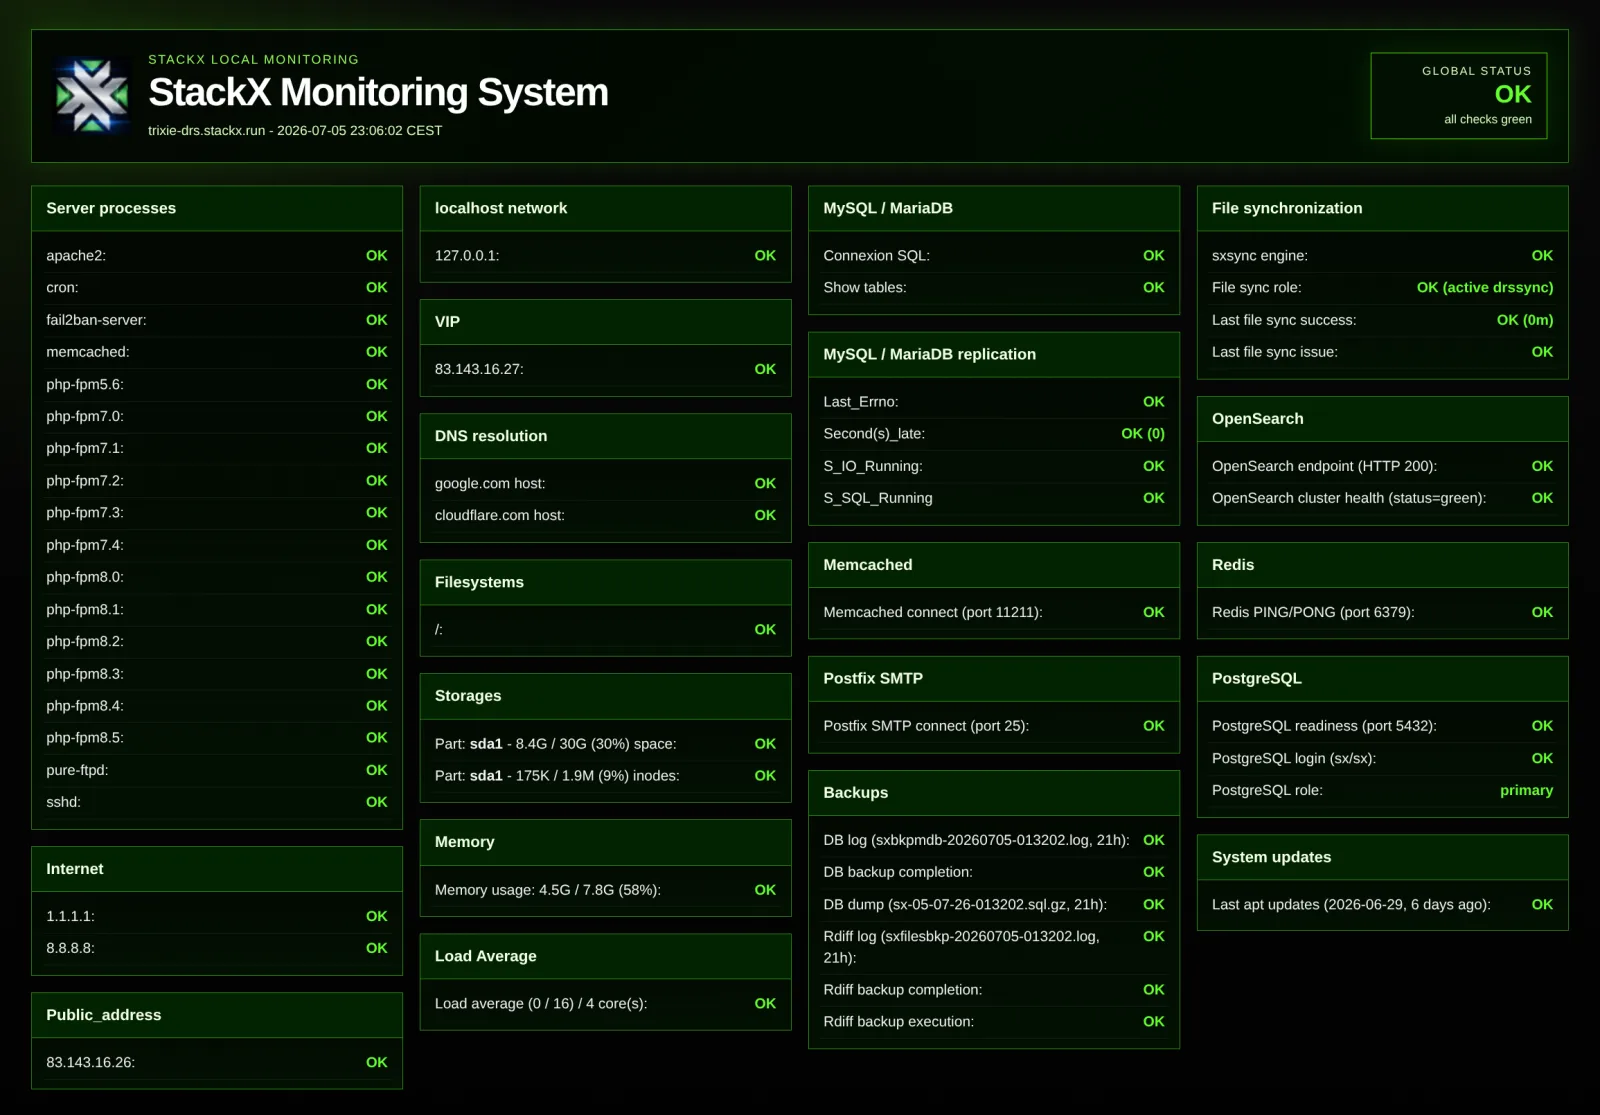
Chaque serveur StackX peut générer dynamiquement son propre état opérationnel local, exposé sous la forme d'un point de contrôle HTTPS dédié. Ce point peut ensuite être vérifié depuis l'extérieur par Pingdom, SolarWinds ou tout autre système capable de contrôler une page web.
L'objectif est de séparer ce qui relève de l'état local du serveur, de la disponibilité du service, du chemin réseau et du point géographique de mesure.
Cette logique devient particulièrement utile sur les architectures multi-providers, multi-pays, multi-continents ou hybrides, où une mesure prise depuis un seul endroit peut donner une lecture incomplète, voire trompeuse, de la réalité opérationnelle.
Supervision décentralisée
Principe de supervision ScalarX
Principe de supervision ScalarX
Principe
Application concrète
État local serveur
Chaque machine peut produire son propre état opérationnel via StackX Monitoring System
Point de vérité exploitable
Un endpoint HTTPS dédié restitue les contrôles locaux dans un format lisible par un outil externe
Contrôle externe
Pingdom, SolarWinds, un autre outil ou un contrôle manuel peuvent interroger ce point de supervision
Tiers de confiance
Le contrôle peut être confié à un acteur externe indépendant de l'infrastructure supervisée
Mesure géographique
Le point de mesure peut être choisi selon la zone, le client, le provider ou le scénario de production
Découplage infrastructure
La supervision n'impose pas un datacenter ScalarX, une région cloud unique ou un agent propriétaire
Exemple d'état local StackX Monitoring System. Chaque serveur peut produire un état opérationnel local lisible, contrôlable depuis l'extérieur via HTTPS par Pingdom, SolarWinds ou un autre outil de supervision.
Ce que la supervision permet de séparer
Ce que la supervision permet de séparer
Question
Lecture opérationnelle
Le serveur va-t-il bien localement ?
Processus attendus, filesystems, services et contrôles locaux remontés par StackX
Le service répond-il ?
Vérification externe du point exposé et des services associés
Le problème vient-il du serveur ?
Corrélation entre état local, processus, services et erreurs remontées
Le problème vient-il du réseau ?
Comparaison entre état local correct et indisponibilité observée depuis un point externe
Le problème dépend-il de la géographie ?
Interprétation selon le pays, le transit, le peering, le CDN, le provider ou le chemin BGP
Pourquoi un monitoring centralisé peut tromper
Pourquoi un monitoring centralisé peut tromper
Situation
Risque d'interprétation
Serveur en Australie, monitoring en Europe
La latence observée ne représente pas forcément l'expérience réelle d'un client aux États-Unis
Application sur plusieurs continents
Un seul point de mesure ne résume pas l'état global du service
Transit ou peering dégradé
L'alerte peut venir du chemin réseau, pas du serveur
Route asymétrique ou congestion temporaire
Une erreur ponctuelle peut refléter Internet, pas l'infrastructure managée
CDN, provider ou région spécifique
La panne peut être localisée sans que le service soit globalement indisponible
Outillage StackX de supervisionSMS, Munin, alertes et contrôles externes
Outillage StackX de supervision
Composant
Rôle
StackX Monitoring System (SMS)
Génère un état local serveur exploitable par un contrôle externe
Point de contrôle HTTPS
Adresse dédiée générée lors du déploiement pour restituer l'état opérationnel sans exposer la structure interne
Profil de contrôle local
Processus, filesystems, services et contrôles attendus selon le rôle de la machine
Évolution progressive
La génération actuelle de SMS peut cohabiter temporairement avec un contrôle historique pendant une migration
Munin
Métriques historiques protégées par authentification HTTPS
sxpostcheck
Audit post-install et contrôle de cohérence des composants StackX
sxnetstat
Lecture réseau opérationnelle, connexions, ports et IPs observées
sxfpmcheck
Contrôle local des pools PHP-FPM, avec modes JSON, full et OpenMetrics
Diagnostics complémentaires StackXCPU, mémoire, stockage et bases de données
Diagnostics complémentaires StackX
Outil
Usage opérationnel
memcalc
Mesure de consommation RAM par service, utilisateur ou PID
sxsqlyze
Analyse MariaDB/MySQL: tailles bases/tables, croissance, fragmentation, moteurs et index
sxpgdb
Inventaire, affichage et doctor des ressources PostgreSQL liées aux environnements
sxmdbsync
Synchronisation MariaDB/MySQL entre environnements, utile pour reprise, tests ou trajectoires PRD/DRS
sxbkpmdb / sxbkppgdb
Sauvegarde MariaDB/MySQL et PostgreSQL avec logs, rétention et contrôles d'exécution
sxserialcheck
Vérification de cohérence des serials DNS entre serveurs de noms
Ce que la supervision n'impose pas
Ce que la supervision n'impose pas
Contrainte absente
Pourquoi c'est important
Pas de plateforme centrale obligatoire
La supervision peut être vérifiée depuis plusieurs outils ou points externes
Pas d'agent propriétaire imposé
Un simple contrôle HTTPS peut suffire pour valider l'état généré localement
Pas de région cloud unique
Les environnements multi-providers ou multi-continents restent supervisables
Pas de topologie réseau figée
Le modèle s'adapte aux serveurs dédiés, cloud public, cloud privé, PRA ou hybride
Pas de dépendance à un datacenter ScalarX
Le serveur conserve la capacité de produire son état opérationnel localement
Contrôles locaux typiquesServices, réseau, sauvegardes et réplication
Contrôles locaux typiques
Contrôle
Exemple StackX
Processus critiques
Apache, SSH, cron, fail2ban, PHP-FPM, Redis, OpenSearch, RabbitMQ ou services spécifiques selon profil
Filesystems
Vérification des points de montage attendus et des volumes critiques
RAID / pools ZFS
Contrôle de l'état des volumes, pools, dégradations ou erreurs selon architecture
Load average
Détection de pression CPU, saturation ou comportement anormal côté système
Consommation RAM
Lecture mémoire par service, utilisateur ou PID avec des outils comme memcalc
Services applicatifs
PHP-FPM par version, bases de données, RabbitMQ, composants applicatifs ou services dédiés
Réplication / synchronisation
Rôle SQL, retard de réplication, état des échanges de fichiers et préparation des synchronisations PRD / DRS
Réseau
Ports exposés, connexions actives, IPs observées et cohérence avec les règles de filtrage
Cohérence post-install
Fichiers StackX, configuration, monitoring, logs, permissions et services attendus
En pratique : ScalarX peut superviser un serveur via son état local StackX, tout en faisant valider cet état par un tiers de confiance comme Pingdom ou SolarWinds. Le contrôle externe reste indépendant de l'infrastructure supervisée, ce qui permet de distinguer plus rapidement une panne serveur, une panne service, un problème de chemin réseau ou une anomalie liée au point de mesure.
Cas d'usage
Cas d'usage
Contexte
Intérêt
Serveur isolé mais critique
Vérifier localement les composants essentiels sans imposer une plateforme lourde
Infrastructure multi-sites
Comparer état local et disponibilité externe selon les zones
PRA / DRS
Contrôler séparément les nœuds de production et de reprise
Multi-provider
Éviter de confondre panne fournisseur, transit réseau et panne serveur
Client international
Adapter les points de mesure à la réalité géographique des utilisateurs
Besoin de cadrer votre supervision ? Nous pouvons définir les contrôles locaux, les points de mesure externes, les seuils d'alerte et la méthode d'interprétation adaptée à votre architecture.